Yapay zeka (AI) endüstrisinde donanım denildiğinde akla ilk gelen ve en çok konuşulan bileşen tartışmasız Grafik İşlem Birimleridir (GPU). Büyük Dil Modellerinin (LLM) trilyonlarca parametresini işlemek ve derin öğrenme ağlarında matris çarpımlarını gerçekleştirmek için GPU’ların paralel işlem yeteneği zorunludur.
Bu algı, sektörde yapay zeka sunucularının (AI Server) devasa ekran kartı yığınlarından ibaret olduğu gibi yanlış bir kanının oluşmasına neden olur. Oysa gerçek dünya uygulamalarında, üretim (Production) ortamına alınan bir AI modeli; verinin diske yazılmasından, ağ üzerinden iletilmesine, CPU tarafından ön işlemlerden (preprocessing) geçirilmesine kadar kompleks bir donanım zincirine ihtiyaç duyar.
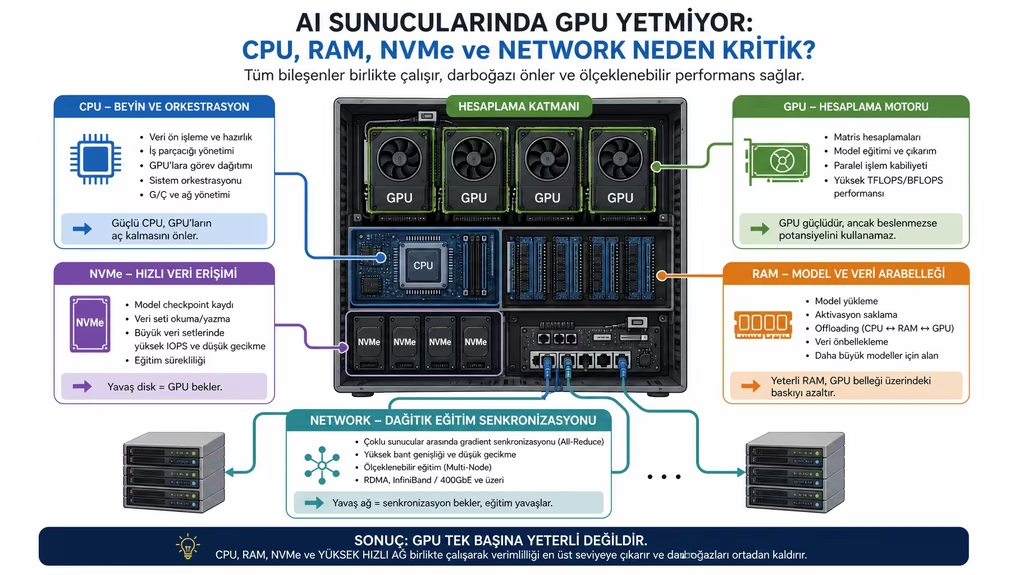
Sistemdeki en yavaş bileşen, tüm operasyonun maksimum hızını belirler. Dünyanın en güçlü GPU’su, eğer işlemci (CPU) veriyi zamanında ulaştıramazsa veya depolama (Storage) sistemi okuma/yazma hızında yetersiz kalırsa, günün büyük bir bölümünü boşta (Idle) bekleyerek geçirir. Bu duruma sistem mimarisinde “Darboğaz” (Bottleneck) adı verilir.
CNCF (Cloud Native Computing Foundation) ve büyük donanım üreticilerinin yayımladığı referans mimariler, yapay zeka sunucularının tamamen heterojen bir altyapı gerektirdiğini göstermektedir. Bu rehberde, yapay zeka iş yüklerinde (Workload) CPU, RAM, NVMe ve Network bileşenlerinin neden en az GPU kadar kritik bir role sahip olduğunu detaylıca inceleyeceğiz.
Veri İşleme Boru Hattı (Data Pipeline) ve Donanım Bağımlılığı
Bir yapay zeka sunucusunun nasıl çalıştığını anlamak için verinin yolculuğunu (Data Pipeline) adım adım takip etmek gerekir. İster model eğitimi (Training), isterse çıkarım (Inference) aşaması olsun, veri şu standart yolu izler:
- Storage (Depolama): Eğitim veri seti veya RAG vektörleri yüksek kapasiteli disklerde saklanır. Veri ilk olarak buradan okunur.
- Network (Ağ): Veriler uzak bir depolama ünitesindeyse (Shared Storage), sunucuya ağ üzerinden iletilir.
- CPU & RAM (Ön İşleme): Ham veri doğrudan GPU’ya gönderilmez. CPU, veriyi alır, decode eder, yeniden boyutlandırır, maskeler veya metinleri token’lara çevirir (Tokenization). Bu işlemler sırasında veri, ana sistem belleğinde (RAM) geçici olarak tutulur.
- GPU (Hesaplama): Ön işlemden geçmiş hazır veri kümesi, PCIe yolları üzerinden VRAM’e aktarılır ve GPU matematiksel hesaplamaları (Matris çarpımları) gerçekleştirir.
- CPU & Network (Son İşlem): GPU’nun ürettiği sayısal vektörler veya logitler, CPU tarafından tekrar insanların anlayabileceği metne veya görüntüye çevrilir (Post-processing) ve ağ üzerinden kullanıcıya iletilir.
Bu beş adımlı yolculukta GPU sadece dördüncü aşamada görev alır. Diğer tüm adımlar sistemin geri kalan donanımlarına bağımlıdır.
Merkezi İşlem Biriminin (CPU) AI Sunucularındaki Rolü
Yapay zeka modellerinin kendi hesaplamaları CPU üzerinde yapılmasa da, CPU tüm sunucunun orkestra şefidir.
Ön İşleme ve Veri Hazırlığı (Data Preprocessing)
Görüntü işleme (Computer Vision) veya makine öğrenimi modellerinde, ham fotoğrafların yeniden boyutlandırılması (Resizing), kırpılması (Cropping) veya normalizasyon işlemleri genellikle GPU’dan önce CPU tarafından yapılır.
Aynı şekilde doğal dil işleme (NLP) modellerinde metnin parçalara ayrılması ve temizlenmesi CPU’ya aittir. Eğer CPU zayıfsa, veriyi hazırlayıp GPU’ya göndermekte gecikir. Bu durumda GPU çalışmayı durdurur ve yeni veri gelmesini bekler. GPU Utilization (Kullanım Verimliliği) düşer ve devasa yatırım yapılan ekran kartı israf edilmiş olur.
Model Orkestrasyonu ve API Yönetimi
Üretim ortamında çalışan yapay zeka sunucuları, Kubernetes (K8s) gibi konteyner orkestrasyon araçları, REST API sunucuları ve model servis araçları (örneğin Triton Inference Server veya vLLM) ile donatılmıştır.
Kullanıcılardan gelen HTTP isteklerini karşılamak, güvenlik politikalarını uygulamak, istekleri topluca birleştirmek (Dynamic Batching) ve yük dengelemesi (Load Balancing) yapmak tamamen CPU’nun görevidir. Sunucuya saniyede binlerce istek geldiğinde, zayıf bir CPU bu istekleri parse edemez (çözümleyemez) ve sistem kilitlenir. Bu nedenle modern AI sunucuları her zaman çok çekirdekli (Multi-Core) ve yüksek frekanslı Intel Xeon veya AMD EPYC işlemcilerle donatılmalıdır.
Sistem Belleği (RAM) Kapasitesinin Önemi
GPU’ların kendi üzerinde HBM (High Bandwidth Memory) veya GDDR tabanlı VRAM’leri bulunur. Ancak sunucunun anakartı üzerindeki ana belleğin (System RAM) kapasitesi, AI iş yükleri için en az VRAM kadar önemlidir. Endüstri standartlarına göre, bir AI sunucusunun RAM kapasitesi, üzerindeki toplam VRAM kapasitesinin genellikle 2 ile 4 katı arasında olmalıdır.
Model Yükleme ve CPU Offloading
Bir model çalıştırılmadan önce (örneğin 140 GB boyutundaki bir model), dosyalar diskten okunur ve önce geçici olarak ana RAM’e alınır. Ardından VRAM’e aktarılır. Ana RAM yetersizse model yüklenirken sistem çöker (OOM – Out of Memory).
Ayrıca VRAM dolduğunda sistem çökmek yerine, en az kullanılan KV Cache verilerini veya bazı hesaplama katmanlarını (Model Offloading) PCIe üzerinden ana RAM’e kaydırır. RAM kapasitesi ne kadar yüksekse, VRAM darboğazı aşıldığında sistemin hata vermeden (biraz yavaşlayarak da olsa) çalışmaya devam etme toleransı o kadar artar.
NVMe Storage (Depolama) Hızının Doğrudan Etkisi
AI sunucularında geleneksel mekanik disklerin (HDD) veya standart SATA SSD’lerin kullanılması mimari bir hatadır. Sistem yüksek IOPS (Saniyedeki Girdi/Çıktı) ve Throughput (İş Hacmi) değerlerine ihtiyaç duyar.
Checkpointing ve Veri Seti Okuma Hızı
Model eğitimi (Training) aşamasında, sistem modelin ulaştığı ağırlık (Weights) durumunu belirli periyotlarla diske yazar (Checkpointing). Eğer disk yavaşsa, bu yazma işlemi dakikalar sürer. O esnada GPU hesaplama yapamaz ve durur. Yüksek yazma hızına sahip kurumsal NVMe diskler bu süreyi saniyelere indirir.
Ayrıca eğitim sırasında model sürekli olarak devasa veri setlerini (Dataset) okumak zorundadır. NVMe SSD’ler, saniyede gigabaytlarca (GB/s) okuma hızı sunarak veri besleme hattını (Data Pipeline) her zaman dolu tutar.
RAG (Retrieval-Augmented Generation) Uygulamaları
Şirket verileri üzerinden cevap üreten RAG mimarilerinde, model cevap vermeden önce Vektör Veritabanında arama yapar. Vektör veritabanları genellikle verinin büyük kısmını diskte tutar. NVMe disklerin düşük gecikme (Latency) süresi, arama sonuçlarının modele milisaniyeler içinde iletilmesini sağlar.
NVIDIA’nın GDS (GPUDirect Storage) gibi teknolojileri, verinin doğrudan NVMe diskten alınarak CPU’ya hiç uğramadan PCIe üzerinden direkt GPU VRAM’ine aktarılmasını (Direct Memory Access) mümkün kılar. Bu işlemin verimli çalışması için depolama altyapısının NVMe standartlarında olması şarttır.
Network (Ağ) Altyapısı Neden Hayati Önem Taşır?
Tek bir sunucunun (Single Node) sınırları aşıldığında ve birden fazla sunucu bir arada çalışmaya (Cluster) başladığında, ağ bağlantısı sistemin en kritik bileşenine dönüşür.
Dağıtık Eğitim (Distributed Training) ve East-West Traffic
Trilyonlarca parametreli bir modeli eğitmek aylar sürer. Bu süreyi kısaltmak için eğitim işlemi onlarca sunucuya (örneğin 64 adet GPU sunucusuna) paylaştırılır. Her bir GPU, yaptığı matematiksel hesaplamanın sonucunu diğer 63 GPU ile saniyede binlerce kez paylaşmak ve senkronize olmak zorundadır.
Sunucular arasındaki bu yatay veri trafiğine (East-West Traffic) standart 1 Gbps veya 10 Gbps Ethernet kartları kesinlikle yetmez. Sunucular veriyi beklerken GPU’lar boşta kalır. Dağıtık sistemlerde sunucuların kendi aralarında haberleşmesi için 100 Gbps veya 400 Gbps hızında InfiniBand veya RDMA over Converged Ethernet (RoCE) destekli özel ağ altyapılarına ihtiyaç duyulur.
Çıkarım (Inference) ve Gecikme (Latency)
Model canlıya alındığında, sunucunun internet çıkış kapasitesi kullanıcı deneyimini belirler. Model metni saniyeler içinde üretse bile, sunucunun genel ağ bağlantısı (Bandwidth) düşükse, üretilen cevap kullanıcının tarayıcısına aktarılırken yavaşlar. Kullanıcı uygulamanın yavaş çalıştığını hisseder.
Ayrıca, dışarıda bir veri gölünde (Data Lake) tutulan büyük verilerin veya konteyner imajlarının (Docker Image) AI sunucusuna hızlı bir şekilde çekilebilmesi için de yüksek hat kapasitelerine sahip ağ arayüz kartları (NIC) gereklidir.
Heterojen Altyapı İhtiyacı
Yapay zeka projelerini hayata geçirirken, “En güçlü GPU’yu almak” yeterli bir altyapı stratejisi değildir. GPU, bir yarış arabasının motoru ise; CPU şasiyi, RAM yakıt tankını, NVMe diskler yakıt pompasını ve Network ise aracın üzerinde gittiği asfaltı temsil eder.
Sistemin tam performansta ve yüksek verimlilikle (Utilization) çalışabilmesi için, sunucudaki her bir bileşenin birbiriyle uyumlu ve darboğaz yaratmayacak kapasitelerde seçilmesi gerekir. Kurumsal yapay zeka dağıtımlarında (Deployment) başarılı olmak, salt ekran kartı gücünden ziyade, uçtan uca tasarlanmış dengeli ve heterojen bir IT altyapısı kurmakla mümkündür.
Kurumsal AI iş yükleriniz için CPU, RAM ve NVMe dengesi doğru kurulmuş kiralık sunucu çözümlerini inceleyebilir; GPU ağırlıklı eğitim ve çıkarım senaryoları için GPU sunucu kiralama seçeneklerini değerlendirebilirsiniz.
Sık Sorulan Sorular
AI sunucularında sadece GPU yeterli olur mu?
Hayır. GPU yalnızca hesaplama katmanında görev alır. Verinin diskten okunması, ağ üzerinden taşınması, CPU tarafından ön işlemden geçirilmesi ve sonuçların kullanıcıya iletilmesi diğer donanım bileşenlerine bağlıdır. Bu zincirdeki en yavaş halka, sistemin toplam performansını belirler.
AI sunucusunda RAM kapasitesi ne kadar olmalı?
Endüstri pratiğinde, sistem RAM kapasitesinin toplam VRAM kapasitesinin 2 ile 4 katı arasında olması önerilir. Bu oran, model yükleme, CPU offloading ve KV Cache taşıma senaryolarında sistemin çökmeden çalışmaya devam etmesini sağlar.
AI sunucularında NVMe neden zorunludur?
NVMe diskler yüksek IOPS ve GB/s seviyesinde okuma-yazma hızı sunar. Checkpointing, veri seti okuma ve RAG aramalarında oluşan gecikmeleri minimize ederek GPU’nun boşta beklemesini engeller. GPUDirect Storage gibi teknolojiler de NVMe altyapısı üzerine kuruludur.
Dağıtık AI eğitiminde neden yüksek hızlı ağ gerekir?
Onlarca GPU sunucusu senkron çalışırken gradyanları saniyede binlerce kez paylaşır. Standart Ethernet kartları bu yatay trafiği (East-West Traffic) taşıyamaz; 100 Gbps veya 400 Gbps InfiniBand / RoCE altyapıları gerekir.